Auditer un Design System pour MCP : retour de mission
Le contexte
On est à un moment charnière pour les équipes design/dev. Avec l'arrivée du Figma MCP server, de Claude Code et plus largement des agents IA dans les workflows quotidiens, le design system n'est plus juste une ressource pour les humains. Il devient une source de vérité que les machines consomment des centaines de fois par jour. Ça change pas mal la donne sur la façon dont on le structure et dont on nomme les choses.
Récemment en mission chez un client, on m'a demandé de jeter un œil au design system en place avec cette perspective. L'objectif c'était de voir comment l'optimiser en vue d'un futur déploiement via MCP (Model Context Protocol), pour pouvoir l'utiliser directement avec Claude Code et fluidifier les allers-retours design/dev.
J'ai bossé avec l'UI designer de l'équipe et honnêtement le travail était déjà bien avancé. Les éléments sont nommés, la structure existe, les composants sont documentés. Ce que j'ai remarqué c'est surtout que le naming, qui fonctionne très bien en usage quotidien avec l'équipe actuelle, pourrait gagner en cohérence pour mieux scaler. C'est un truc assez normal, la plupart des DS que j'ai pu voir évoluent de manière organique et à un moment donné il faut prendre du recul pour harmoniser.
Le constat de fond c'est simple : les petites incohérences qu'un dev humain corrige instinctivement deviennent de vrais sujets dès qu'on branche un agent IA dessus, parce que l'IA prend tout au pied de la lettre.
Je partage ici ce que j'ai pu observer et quelques pistes d'amélioration. C'est pas des vérités absolues, c'est ce qui a fonctionné dans les contextes où je suis intervenu et qui me semble applicable assez largement.
Un principe qui peut servir de fil rouge pour tout ce qui suit : un développeur qui n'a jamais vu vos tokens devrait pouvoir deviner raisonnablement ce qu'un token fait. Si un nom nécessite un savoir spécifique ou un collègue pour l'interpréter, c'est probablement un bon candidat au renommage. Ce test marche aussi pour l'IA : si un humain qui découvre le DS a du mal à deviner le rôle d'un token, l'IA aura exactement le même problème.
Ce que j'ai pu observer et les pistes d'amélioration
1. La direction de lecture des noms peut varier
C'est probablement le truc le plus courant et le plus compréhensible. Quand plusieurs personnes contribuent au DS sur la durée, chacun nomme avec sa propre logique et individuellement ça se tient. C'est juste qu'à l'échelle ça peut devenir un peu dur à scanner.
Les noms sont plus faciles à scanner quand ils vont du concept le plus large vers la spécificité. Ça fait aussi que les listes triées alphabétiquement regroupent naturellement les tokens liés ensemble.
Une piste qui marche bien c'est de toujours aller du large au précis :
color.background.hover   plutôt que   hover.background.color
color.text.primary       plutôt que   primary.text.color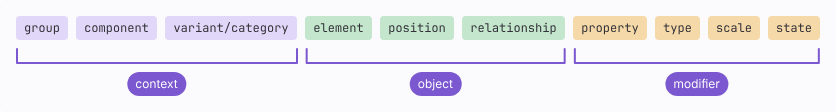
La convention de nommage permet de choisir un design token qui correspond à l'intention de design. Les noms de tokens peuvent inclure des termes qui définissent le contexte, l'objet et le modificateur. Par exemple :
[group].[component].[variant/category].[element].[position].[relationship].[property].[type].[scale].[state]Ça a l'air anodin mais sur une liste de 200+ tokens ça change vraiment la lisibilité.
Le lien avec le MCP : quand l'IA appelle get_tokens("color"), elle reçoit la liste de tous les tokens couleur. Si la direction de lecture est cohérente, tous les tokens de background se retrouvent groupés, tous les tokens de texte aussi. L'IA identifie le bon token en une lecture au lieu de scanner une liste désordonnée.
2. Une hiérarchie entre les niveaux de tokens peut aider
Un truc que j'ai souvent vu c'est que tous les tokens vivent au même niveau. Les valeurs brutes cohabitent avec les tokens sémantiques sans distinction claire. Ça marche bien quand l'équipe connaît le système par cœur, mais ça peut poser souci quand l'IA ou un nouveau dev doit s'y retrouver.
La plupart des systèmes matures suivent un modèle à trois niveaux. C'est une approche qui a fait ses preuves et qui pourrait être intéressante à adopter.
Tier 1 : les primitives (valeurs brutes)
Au lieu d'utiliser des codes hex directement, on nomme les couleurs avec des valeurs tonales de 0 à 100 (ou 100 à 1000). Chaque valeur exprime la quantité de lumière dans la couleur.
color.blue.400
color.neutral.70
space.4
font.size.16
Ces tokens sont la fondation. Ils sont agnostiques de la plateforme et ne portent pas de sens sémantique. C'est juste le catalogue de toutes les valeurs disponibles.
Tier 2 : les tokens sémantiques (alias)
C'est là qu'on donne un rôle à une valeur. Un alias pointe vers une primitive mais dit clairement à quoi ça sert :
color.text.primary       → color.neutral.10
color.background.danger  → color.red.500
color.border.default     → color.neutral.80
Les alias permettent de changer de thème (dark mode, personnalisation de marque) simplement en remappant les valeurs. Le nom du token reste le même, la sortie s'adapte.
Tier 3 : les tokens de composant
Scopés à un composant précis :
button.color.background.primary
button.color.background.primary.hover
input.color.border.error
Ils héritent des tokens alias mais sont scopés au contexte du composant.
Le lien avec le MCP : sans cette hiérarchie, quand l'IA appelle get_tokens, elle reçoit une liste plate de 300 tokens et elle pioche au hasard. Avec les 3 tiers elle comprend que color.text.primary est le bon choix sémantique pour du texte et pas color.neutral.10 qui est juste la valeur brute derrière. C'est la différence entre un composant généré qui a du sens et un composant qui compile mais qui utilise des valeurs arbitraires.
!Architecture en trois niveaux : primitives, alias sémantiques, tokens de composant
3. Ajouter une notion de rôle aux couleurs
C'est un cas concret que j'ai vécu sur cette mission. Un token blue-dark était utilisé comme background d'alerte dans un composant et comme couleur d'accent dans un autre. Quand l'IA a généré un nouveau composant de card, elle a appliqué blue-dark sur le background parce que le nom ne portait aucune intention d'usage. C'est pas que le naming était faux, c'est qu'il décrivait la teinte au lieu de la fonction.
En le renommant avec une logique de rôle, le problème a disparu. La structure qui revient souvent dans les DS qui scalent bien c'est : prefix-color-{rôle}-{modifier}-{thème}. Le rôle définit la fonction (accent, border, text, status, surface). Le modifier est optionnel et inclut des variations comme weak, strong, active, hover ou success.
ds-color-accent
ds-color-border-strong
ds-color-text-weak
ds-color-status-success
Le rôle en premier permet à n'importe qui de comprendre immédiatement où ça s'applique, sans avoir besoin de contexte supplémentaire.
Le lien avec le MCP : l'IA qui cherche une couleur pour un état d'erreur va naturellement matcher ds-color-status-danger plutôt que de deviner que red-500 c'est « la couleur qu'on utilise pour les erreurs chez nous ».
4. Harmoniser les échelles de taille
J'ai remarqué que les différentes catégories (espacements, radius, typo) utilisaient chacune leur propre logique d'échelle. C'est assez naturel quand les catégories ont été créées à des moments différents par des personnes différentes.
Les tailles définies avec des T-shirt sizes permettent à n'importe qui, technique ou non, de comprendre les différences et comment elles se rapportent entre elles. On utilise toujours la forme courte (s, m, l, xl).
space-xs, space-s, space-m, space-l, space-xl
radius-s, radius-m, radius-l
font-size-s, font-size-m, font-size-l
Avoir la même logique partout réduit la charge cognitive, autant pour les humains que pour l'IA.
5. Penser au préfixe système
C'est un détail qui peut sembler secondaire aujourd'hui mais qui devient important avec le MCP. Les noms de tokens qui commencent par un préfixe évitent les conflits avec d'autres systèmes.
Si le DS s'appelle « Pulse » par exemple :
pulse-color-text-primary
pulse-space-m
pulse-font-size-l
Le lien avec le MCP : l'IA va potentiellement manipuler des tokens de sources différentes (votre DS, une lib tierce, des tokens Tailwind...). Le préfixe lui permet de savoir immédiatement ce qui vient de votre système et ce qui vient d'ailleurs.
6. Fixer un casing unique
Un petit point d'attention que j'ai noté : les tokens avec le même nom mais des majuscules différentes sont vus comme des tokens uniques par le système. Par exemple tokenName, tokenname et Tokenname seront tous traités comme des tokens différents.
Choisir un format (kebab-case est le plus courant) et s'y tenir partout, ça évite des bugs silencieux assez pénibles à débugger.
7. Quelques pièges techniques à avoir en tête
Des petits trucs à anticiper pour éviter des surprises au moment de la transformation en code :
Quand on utilise des points comme séparateurs de groupes, attention aux demi-pas. Par exemple entre spacing.1 et spacing.2, écrire spacing.1.5 peut poser problème parce que les outils de transformation côté dev risquent de créer des collisions de noms.
Les noms de tokens ne peuvent pas commencer par le caractère $, et il vaut mieux éviter les accolades dans les noms car elles sont réservées aux références entre tokens.
Faire vivre le naming dans la durée
Un point que je vois souvent négligé : le naming c'est pas un chantier qu'on fait une fois et qu'on oublie. Le vrai risque c'est la dérive à 6 mois, quand de nouveaux composants arrivent et que chacun reprend ses habitudes.
Quelques pistes qui marchent bien pour éviter ça :
Un owner clairement identifié. Quelqu'un dans l'équipe (souvent le designer ou le lead front) qui valide les noms des nouveaux tokens avant qu'ils soient mergés. Ça peut être aussi simple qu'un check dans la PR.
Une convention documentée en une page. Pas un doc de 20 pages que personne lit. Juste les règles de base : la direction de lecture, le casing, le préfixe, les rôles couleurs, l'échelle de taille. Si ça tient pas sur une page A4, c'est trop complexe.
Le générateur qui protège les sections curées. Les valeurs de tokens et le markup sont extraits automatiquement de la source parce que si on les écrit à la main ils dérivent. Mais les descriptions, anti-patterns et patterns de haut niveau sont rédigés manuellement parce qu'ils représentent une intention et un jugement humain. Le générateur doit toujours préserver ces sections curées quand il régénère le reste. Sinon quelqu'un lance npm run generate et tout le travail éditorial disparaît.
Un check périodique. Tous les trimestres ou à chaque release majeure, on repasse sur la liste des tokens avec le test du « nouveau dev » : est-ce qu'un inconnu comprendrait chaque nom sans aide ?
Ce que ça donne côté MCP concrètement
Pour ceux qui découvrent le sujet : l'idée c'est de donner à l'IA une interface interrogeable vers le design system en temps réel, un serveur MCP qu'elle appelle à la demande quand elle a besoin de connaître le markup exact d'un composant ou la bonne valeur d'un token.
L'objectif c'est d'éliminer les noms de classes inventés, le markup deviné et les valeurs de tokens approximées, en laissant l'IA chercher la vérité plutôt que deviner.
Le serveur est volontairement mince : il charge du JSON pré-généré au démarrage, formate les réponses et les sert. Pas de base de données, pas de parsing au runtime. L'IA peut interroger des outils comme get_component("modal") pour récupérer le markup canonique avec les variantes et les anti-patterns, ou get_tokens("color") pour obtenir la liste structurée des tokens couleur avec leur hiérarchie.
Une fois ce système en place, l'itération devient extrêmement rapide. Chaque itération prend quelques secondes. Et le cycle peut même boucler dans l'autre sens : Claude Code to Figma permet de capturer une UI fonctionnelle et de la convertir en frames éditables dans Figma, ce qui crée un vrai aller-retour design/code/design sans perte de contexte.
Pour le déploiement à l'échelle de l'équipe, les serveurs à portée projet stockent les configs dans un .mcp.json à la racine du projet, conçu pour être versionné. Vos devs ont tous les mêmes outils dès le git clone.
En résumé
L'investissement est concentré en amont mais le bénéfice se compose dans la durée : chaque composant généré par l'IA qui utilise le bon nom, la bonne valeur et le bon markup, sans cycle de revue manuelle pour corriger les hallucinations.
Dans la grande majorité des DS que j'ai pu voir, les fondations sont solides. C'est souvent une question d'harmonisation et de mise en cohérence du naming, pas du tout une refonte. Et le passage au MCP c'est une bonne occasion de prendre ce temps parce que le retour sur investissement est concret et mesurable : moins de revues manuelles, moins de corrections post-génération, et un langage vraiment partagé entre les designers, les devs et maintenant les agents IA.
---
À lire aussi : pour la vue d'ensemble sur pourquoi tout ça compte vraiment, Le design adaptatif personnalisé par l'IA. Et sur l'art de diagnostiquer le bon problème avant de concevoir le système, Deep Systemic Design.
---
Sources & références
1. Louis Chenais, Design Tokens Book, l'ouvrage de référence sur l'architecture, les niveaux et le nommage des tokens. designtokens.book
2. W3C Design Tokens Community Group, la spec officielle qui définit $type, $value et les caractères réservés. w3.org/community/design-tokens
3. Nathan Curtis, Naming Tokens in Design Systems (EightShapes), l'article fondateur sur le nommage par niveaux et la règle du large vers le précis. medium.com/eightshapes-llc
4. Anthropic, Model Context Protocol, la spécification officielle du MCP. modelcontextprotocol.io
5. Figma, Dev Mode MCP Server, documentation officielle. help.figma.com
6. Brad Frost, Design Tokens FAQs, sur le modèle à trois niveaux. bradfrost.com