Ein Design System für MCP auditieren: Notizen aus dem Einsatz
Der Kontext
Wir stehen an einem Wendepunkt für Design- und Dev-Teams. Mit dem Figma MCP Server, Claude Code und KI-Agenten in den täglichen Workflows ist das Design System nicht länger nur eine Ressource für Menschen. Es wird zur Wahrheitsquelle, die Maschinen hunderte Male pro Tag konsumieren. Das verändert maßgeblich, wie wir es strukturieren und Dinge benennen.
Kürzlich war ich bei einem Kunden im Einsatz und sollte das bestehende Design System aus dieser Perspektive betrachten. Ziel war es, das System für einen kommenden MCP-Rollout (Model Context Protocol) zu optimieren, damit es direkt mit Claude Code genutzt werden kann und die Iterationsschleifen zwischen Design und Entwicklung beschleunigt.
Ich habe mit der UI-Designerin des Teams gearbeitet und ehrlich gesagt war die Arbeit schon weit vorangeschritten. Komponenten sind benannt, die Struktur existiert, alles ist dokumentiert. Was mir aufgefallen ist: Das Naming, das im Alltag mit dem aktuellen Team sehr gut funktioniert, könnte an Konsistenz gewinnen, um besser zu skalieren. Das ist ziemlich normal, die meisten DS, die ich gesehen habe, entwickeln sich organisch und irgendwann braucht es einen Schritt zurück, um zu harmonisieren.
Der Kern des Problems ist einfach: Die kleinen Inkonsistenzen, die ein menschlicher Entwickler instinktiv korrigiert, werden zu echten Themen, sobald man einen KI-Agenten anschließt, weil die KI alles wörtlich nimmt.
Ich teile hier meine Beobachtungen und ein paar Verbesserungsansätze. Das sind keine absoluten Wahrheiten. Es ist das, was in den Kontexten funktioniert hat, in denen ich aktiv war, und was mir breit anwendbar erscheint.
Ein Prinzip als roter Faden für alles Folgende: Ein Entwickler, der eure Tokens noch nie gesehen hat, sollte vernünftig erraten können, was ein Token tut. Wenn ein Name spezifisches Wissen oder einen Kollegen zur Erklärung braucht, ist er wahrscheinlich ein guter Kandidat für Umbenennung. Der Test gilt auch für die KI: Wenn ein Mensch beim ersten Blick die Rolle eines Tokens schwer erraten kann, hat die KI exakt dasselbe Problem.
Was ich beobachtet habe und die Verbesserungsansätze
1. Die Leserichtung der Namen kann variieren
Wahrscheinlich das häufigste und nachvollziehbarste Problem. Wenn mehrere Personen über die Zeit am DS mitarbeiten, benennt jeder nach eigener Logik und einzeln betrachtet hält das stand. Im Maßstab wird es nur etwas schwer zu scannen.
Namen sind leichter zu scannen, wenn sie vom breitesten Konzept zum Spezifischen führen. Alphabetisch sortierte Listen gruppieren so verwandte Tokens automatisch.
Ein Ansatz, der gut funktioniert, ist immer vom Allgemeinen zum Spezifischen zu gehen:
color.background.hover   statt   hover.background.color
color.text.primary       statt   primary.text.color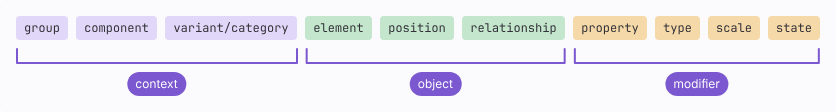
Die Naming Convention erlaubt es, einen Design Token zu wählen, der zur Design-Intention passt. Token-Namen können Begriffe enthalten, die Kontext, Objekt und Modifier eines Design Tokens definieren. Zum Beispiel:
[group].[component].[variant/category].[element].[position].[relationship].[property].[type].[scale].[state]Klingt nebensächlich, aber bei einer Liste mit 200+ Tokens ändert das die Lesbarkeit wirklich.
Der MCP-Bezug: Wenn die KI get_tokens("color") aufruft, bekommt sie die gesamte Liste der Farb-Tokens. Ist die Leserichtung konsistent, gruppieren sich alle Background-Tokens, alle Text-Tokens ebenfalls. Die KI identifiziert das richtige Token in einem Lesevorgang, statt eine ungeordnete Liste zu scannen.
2. Eine Hierarchie zwischen den Token-Ebenen kann helfen
Etwas, das ich oft sehe: Alle Tokens leben auf derselben Ebene. Rohwerte und semantische Tokens stehen ohne klare Unterscheidung nebeneinander. Das funktioniert, wenn das Team das System in- und auswendig kennt, wird aber schwierig, sobald die KI oder ein neuer Entwickler sich zurechtfinden muss.
Reife Systeme folgen einem Drei-Ebenen-Modell. Ein bewährter Ansatz, der sich zu übernehmen lohnt.
Tier 1: Primitiven (Rohwerte)
Statt Hex-Codes direkt zu verwenden, werden Farben mit Tonwerten von 0 bis 100 (oder 100 bis 1000) benannt. Jeder Wert drückt aus, wie viel Licht in der Farbe steckt.
color.blue.400
color.neutral.70
space.4
font.size.16
Diese Tokens sind das Fundament. Plattformagnostisch, ohne semantische Bedeutung. Einfach der Katalog aller verfügbaren Werte.
Tier 2: semantische Tokens (Aliase)
Hier gibt man einem Wert eine Rolle. Ein Alias zeigt auf eine Primitive, sagt aber klar, wofür es da ist:
color.text.primary       → color.neutral.10
color.background.danger  → color.red.500
color.border.default     → color.neutral.80
Aliase erlauben Themenwechsel (Dark Mode, Branding) durch reines Remapping. Der Tokenname bleibt gleich, das Ergebnis passt sich an.
Tier 3: Komponenten-Tokens
Auf eine bestimmte Komponente begrenzt:
button.color.background.primary
button.color.background.primary.hover
input.color.border.error
Sie erben von den Aliasen, sind aber an einen Komponentenkontext gebunden.
Der MCP-Bezug: Ohne diese Hierarchie bekommt die KI bei get_tokens eine flache Liste mit 300 Tokens und greift zufällig zu. Mit den drei Tiers versteht sie, dass color.text.primary die richtige semantische Wahl für Text ist, nicht color.neutral.10, das nur der Rohwert dahinter ist. Das ist der Unterschied zwischen einer generierten Komponente, die Sinn ergibt, und einer, die kompiliert, aber willkürliche Werte verwendet.
!Drei-Ebenen-Tokenarchitektur: Primitiven, semantische Aliase, Komponenten-Tokens
3. Den Farben einen Rollenbegriff geben
Ein konkreter Fall aus dieser Mission: Ein Token blue-dark wurde in einer Komponente als Alert-Background verwendet und in einer anderen als Akzentfarbe. Als die KI eine neue Card-Komponente generierte, wendete sie blue-dark auf den Background an, weil der Name keine Nutzungsabsicht trug. Das Naming war nicht falsch, es beschrieb den Farbton statt der Funktion.
Mit einer Rollenlogik umbenannt verschwand das Problem. Die Struktur, die sich bei skalierenden DS oft zeigt, ist: prefix-color-{Rolle}-{Modifier}-{Theme}. Die Rolle definiert die Funktion (accent, border, text, status, surface). Der Modifier ist optional und enthält Varianten wie weak, strong, active, hover oder success.
ds-color-accent
ds-color-border-strong
ds-color-text-weak
ds-color-status-success
Die Rolle zuerst macht für jeden sofort klar, wo es greift, ohne weiteren Kontext.
Der MCP-Bezug: Eine KI, die eine Farbe für einen Fehlerzustand sucht, matcht natürlich ds-color-status-danger, statt zu raten, dass red-500 „die Farbe ist, die wir bei uns für Fehler nutzen".
4. Größenskalen harmonisieren
Mir ist aufgefallen, dass die einzelnen Kategorien (Spacings, Radien, Typografie) jeweils eine eigene Skalenlogik nutzten. Das ist recht natürlich, wenn Kategorien zu unterschiedlichen Zeitpunkten von unterschiedlichen Personen entstanden sind.
T-Shirt-Größen erlauben jedem, technisch oder nicht, Verhältnisse sofort zu erfassen. Immer Kurzform (s, m, l, xl).
space-xs, space-s, space-m, space-l, space-xl
radius-s, radius-m, radius-l
font-size-s, font-size-m, font-size-l
Dieselbe Logik überall reduziert die kognitive Last, für Menschen wie für KI.
5. Den System-Präfix mitdenken
Ein Detail, das heute nebensächlich klingt, mit MCP aber wichtig wird. Tokennamen, die mit einem Präfix beginnen, vermeiden Kollisionen mit anderen Systemen.
Heißt das DS zum Beispiel „Pulse":
pulse-color-text-primary
pulse-space-m
pulse-font-size-l
Der MCP-Bezug: Die KI hantiert potenziell mit Tokens aus verschiedenen Quellen (eurem DS, einer Drittlib, Tailwind-Tokens...). Der Präfix lässt sie sofort erkennen, was aus eurem System kommt und was nicht.
6. Ein einheitliches Casing festlegen
Ein kleiner Punkt, der mir aufgefallen ist: Tokens mit gleichem Namen, aber unterschiedlicher Groß-/Kleinschreibung gelten als unterschiedliche Tokens. tokenName, tokenname und Tokenname werden alle separat behandelt.
Ein Format wählen (kebab-case ist am verbreitetsten) und überall durchhalten. Das vermeidet stille Bugs, die ziemlich nervig zu debuggen sind.
7. Ein paar technische Stolpersteine im Hinterkopf
Kleine Dinge, die man bei der Code-Transformation vorausdenken sollte:
Punkte als Gruppentrennzeichen vertragen keine Halbschritte. Zwischen spacing.1 und spacing.2 kann spacing.1.5 Probleme bereiten, weil die dev-seitigen Transformationswerkzeuge Namens-Kollisionen erzeugen können.
Tokennamen dürfen nicht mit dem Zeichen $ beginnen, und geschweifte Klammern sollten in Namen vermieden werden, da sie für Token-Referenzen reserviert sind.
Das Naming langfristig am Leben halten
Ein oft vernachlässigter Punkt: Naming ist kein einmaliges Projekt, das man abschließt und vergisst. Das eigentliche Risiko ist die Drift in sechs Monaten, wenn neue Komponenten kommen und jeder zu seinen Gewohnheiten zurückkehrt.
Ein paar Ansätze, die gut funktionieren:
Ein klar identifizierter Owner. Jemand im Team (oft die Designerin oder der Frontend-Lead), der die Namen neuer Tokens vor dem Merge validiert. So einfach wie ein Check im PR.
Eine einseitige Konvention. Kein 20-seitiges Dokument, das niemand liest. Nur die Grundregeln: Leserichtung, Casing, Präfix, Farbrollen, Größenskala. Wenn es nicht auf eine A4-Seite passt, ist es zu komplex.
Ein Generator, der kuratierte Abschnitte schützt. Tokenwerte und Markup werden automatisch aus der Quelle extrahiert, weil sie händisch verfasst driften würden. Aber Beschreibungen, Anti-Patterns und High-Level-Patterns werden manuell geschrieben, weil sie Intention und menschliches Urteil repräsentieren. Der Generator muss diese kuratierten Abschnitte beim Regenerieren immer bewahren. Sonst startet jemand npm run generate und die gesamte redaktionelle Arbeit verschwindet.
Ein periodischer Check. Jedes Quartal oder bei jedem Major Release geht man die Tokenliste mit dem „neuer Entwickler"-Test durch: Würde jemand Fremdes jeden Namen ohne Hilfe verstehen?
Wie das auf der MCP-Seite konkret aussieht
Für alle, die das Thema neu entdecken: Die Idee ist, der KI eine in Echtzeit abfragbare Schnittstelle zum Design System zu geben, einen MCP-Server, den sie bei Bedarf aufruft, wenn sie das exakte Markup einer Komponente oder den richtigen Tokenwert braucht.
Ziel: erfundene Klassennamen, geratenes Markup und annähernde Tokenwerte eliminieren, indem die KI die Wahrheit abruft, statt zu raten.
Der Server ist bewusst schlank: Er lädt vorgenerierte JSON-Daten beim Start, formatiert Antworten und liefert sie aus. Keine Datenbank, kein Parsing zur Laufzeit. Die KI kann Tools wie get_component("modal") aufrufen, um das kanonische Markup mit Varianten und Anti-Patterns zu holen, oder get_tokens("color"), um die strukturierte Liste der Farb-Tokens mit ihrer Hierarchie zu bekommen.
Ist das System eingerichtet, wird die Iteration extrem schnell. Jede Iteration dauert wenige Sekunden. Und der Zyklus kann sogar in die andere Richtung schließen: Claude Code to Figma erlaubt es, eine funktionierende UI zu erfassen und in editierbare Figma-Frames zu überführen, was einen echten design/code/design-Roundtrip ohne Kontextverlust schafft.
Für den teamweiten Rollout speichern projektscopierte Server ihre Konfiguration in einer .mcp.json im Projekt-Root, gedacht zum Versionieren. Eure Entwickler haben alle dieselben Tools direkt nach git clone.
Zusammengefasst
Die Investition ist vorgelagert, der Nutzen kumuliert sich über die Zeit: Jede von der KI generierte Komponente nutzt den richtigen Namen, den richtigen Wert und das richtige Markup, ohne manuelle Review-Zyklen zur Korrektur von Halluzinationen.
In der überwiegenden Mehrheit der DS, die ich gesehen habe, sind die Grundlagen solide. Es ist oft eine Frage von Harmonisierung und Naming-Abgleich, kein Redesign. Und der Übergang zu MCP ist ein guter Anlass, sich diese Zeit zu nehmen, weil der Return on Investment konkret und messbar ist: weniger manuelle Reviews, weniger Korrekturen nach der Generierung und eine wirklich gemeinsame Sprache zwischen Designern, Entwicklern und jetzt KI-Agenten.
---
Weiterlesen: für das größere Bild, warum das wirklich zählt, AI-personalisiertes adaptives Design. Zur Kunst, das richtige Problem zu diagnostizieren, bevor man das System entwirft, Deep Systemic Design.
---
Quellen & Referenzen
1. Louis Chenais, Design Tokens Book, das Referenzwerk zu Tokenarchitektur, Ebenen und Naming. designtokens.book
2. W3C Design Tokens Community Group, die offizielle Spec zu $type, $value und reservierten Zeichen. w3.org/community/design-tokens
3. Nathan Curtis, Naming Tokens in Design Systems (EightShapes), Grundlagenartikel zu ebenenbasiertem Naming und der Regel vom Allgemeinen zum Spezifischen. medium.com/eightshapes-llc
4. Anthropic, Model Context Protocol, offizielle MCP-Spezifikation. modelcontextprotocol.io
5. Figma, Dev Mode MCP Server, offizielle Dokumentation. help.figma.com
6. Brad Frost, Design Tokens FAQs, zum Drei-Ebenen-Modell. bradfrost.com